Una PWA per trovare film e serie che usa il gusto dell'utente per evolvere i consigli nel tempo.
Il problema
Sglitch risolve un problema molto semplice ma reale: scegliere cosa guardare è diventato difficile non per mancanza di contenuti, ma per eccesso di scelta e raccomandazioni troppo generiche.
I motori tradizionali lavorano soprattutto per genere, popolarità, cast o somiglianza con titoli già visti. Sglitch prova invece a costruire nel tempo una rappresentazione più ricca del gusto dell’utente: cosa salva, cosa scarta, quali titoli considera interessanti, quali pattern emergono tra film e serie.
La soluzione
La soluzione è quindi un motore di discovery cinematografica AI-based che combina:
- TMDB API per recuperare dati strutturati su film e serie;
- Claude API per interpretare preferenze, relazioni e segnali meno rigidi;
- un profilo utente che evolve con le interazioni;
- liste e segnali di interesse che alimentano le raccomandazioni successive;
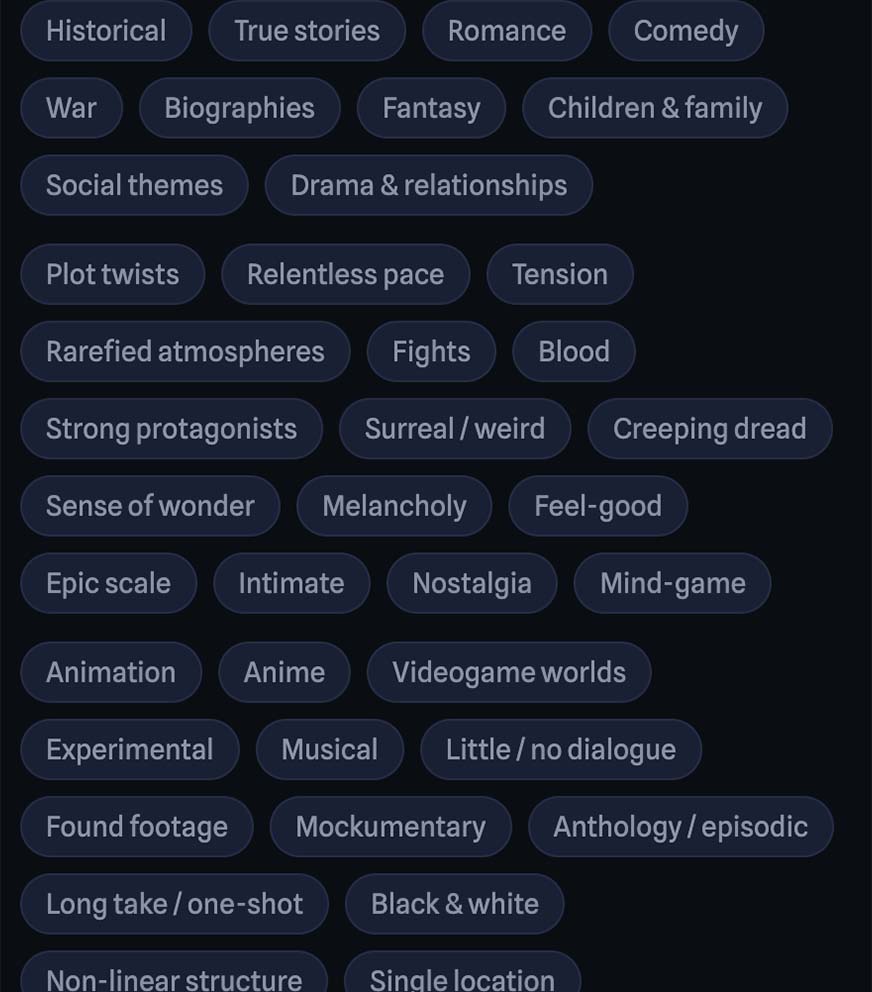
- una UI che permette di esplorare il catalogo senza limitarsi a una ricerca per titolo o genere.
Cosa ho costruito
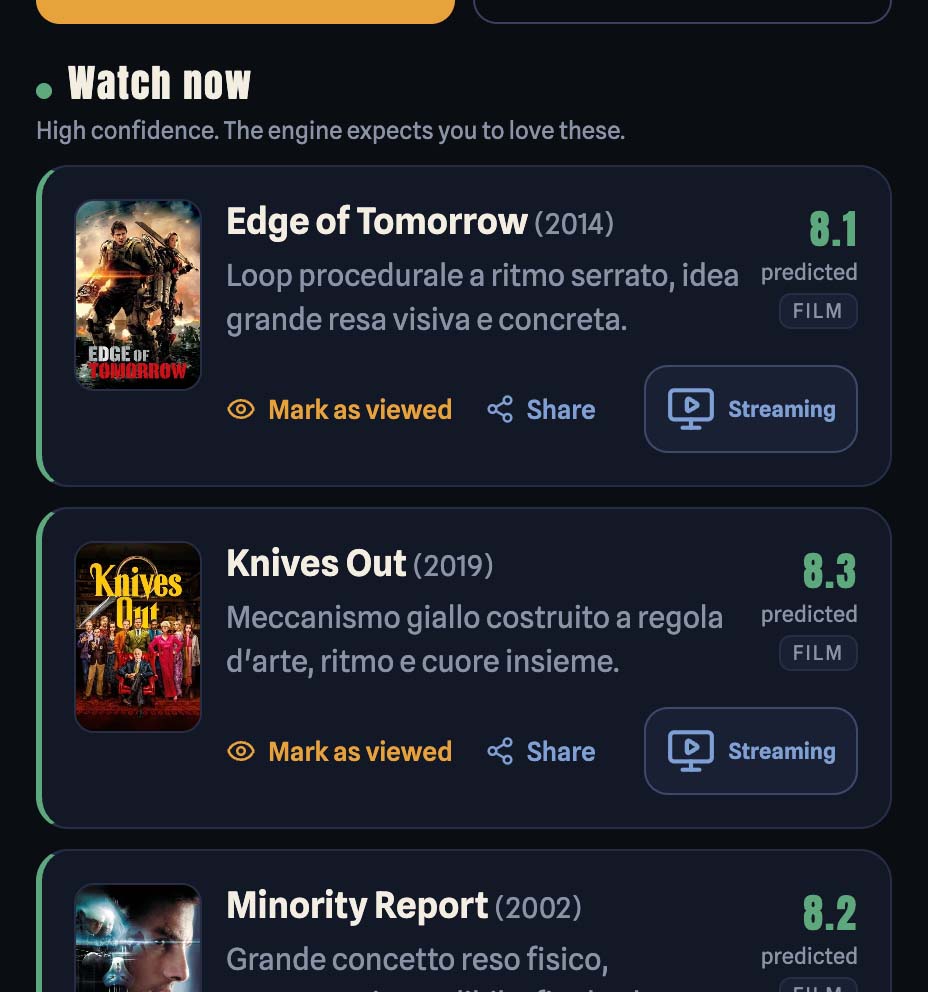
Ho costruito un esperienza React e Vite con API Node ed Express, persistenza MySQL e integrazioni Claude e TMDB.
Come funziona
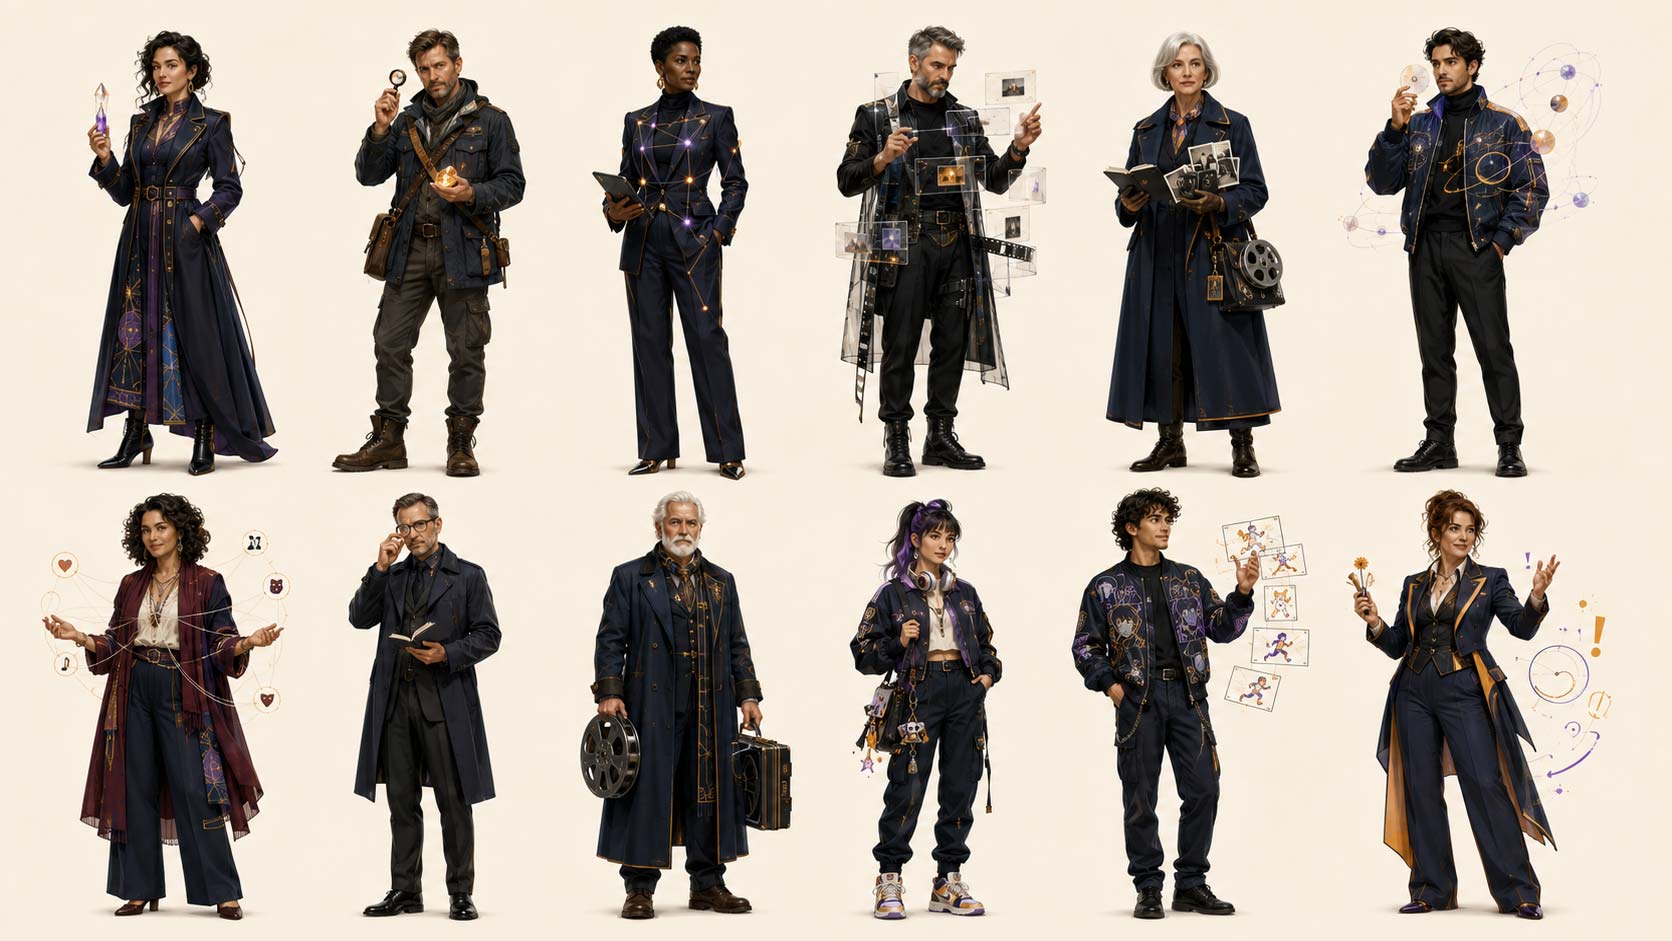
Discovery > segnali di interesse > profilo gusti > ranking e raccomandazioni > liste personali > archivio memoria + evoluzione livelli avatar
Scelte di engineering
- React + Vite per il frontend: scelta adatta a un’interfaccia molto interattiva, con profili, liste, segnali di interesse e navigazione dinamica. Vite mantiene il progetto leggero e rapido da sviluppare.
- Node.js + Express per il backend: layer applicativo semplice per orchestrare richieste dal frontend, accesso al database e chiamate alle API esterne senza esporre direttamente credenziali o logica sensibile nel browser.
- MySQL per la persistenza: il gusto dell’utente non può vivere solo nella sessione. Profili, liste, segnali e interazioni devono essere conservati e riutilizzati per far evolvere il sistema nel tempo.
- TMDB API come fonte strutturata: titoli, cast, generi, immagini, metadati e catalogo provengono da una sorgente specializzata invece di essere ricostruiti o generati dall’AI.
- Claude API come layer interpretativo: l’LLM viene usato dove serve comprensione semantica — leggere relazioni tra preferenze, interessi e titoli — non per sostituire il catalogo strutturato.
- Separazione tra dati e interpretazione: TMDB risponde alla domanda “che cosa esiste e quali caratteristiche ha?”; Claude aiuta a rispondere “perché potrebbe interessare a questa persona?”.
- Profilo utente evolutivo: le interazioni non vengono trattate come eventi isolati. Salvataggi, scarti, liste e segnali di interesse alimentano uno stato persistente che modifica le raccomandazioni successive.
- Recommendation/discovery invece di semplice search: l’architettura è progettata perché il risultato dipenda non solo dalla query corrente, ma anche dalla storia e dal profilo costruito.
- PWA: scelta utile per dare all’app un comportamento più vicino a un prodotto installabile e persistente rispetto a un semplice sito web.
- PostHog: per il monitoraggio delle attività in app, scelto per la sua leggerezza e integrabilità.
Risultato
Un prodotto di discovery che usa ogni interazione per migliorare il profilo dell utente, non solo per restituire risultati di ricerca.