Usare Langfuse per rendere testabile e migliorabile la qualità dell'output di un workflow AI-assisted che qualifica aziende B2B travel in base a rilevanza settore, modello di business e orientamento API o infrastruttura.
Il problema
Il problema iniziale era questo: nella V1 avevamo affidato all'LLM sia la classificazione sia il reasoning. Il risultato cambiava tra un'esecuzione e l'altra. La prima versione era al 66,7% di accuracy; con una rubric più esplicita siamo arrivati all'86,7–93,3%, ma restava variabilità. La V3 ha quindi spostato nel codice deterministico ciò che non aveva motivo di essere probabilistico: rilevamento dei segnali, classificazione del segmento e azione consigliata. All'LLM sono rimasti fit_score e reasoning qualitativo. Sul benchmark di 15 aziende simulate, questa architettura ha ottenuto 15/15 classificazioni corrette.
Perché abbiamo usato Langfuse
Perché una volta introdotto un LLM nasce un secondo problema: come capisci se il comportamento dell'AI sta migliorando o peggiorando?
La soluzione
Il progetto, in concreto, simula un processo di lead qualification B2B per un'azienda SaaS ipotetica che vende infrastruttura API al settore travel. Valuta ogni azienda secondo tre segnali: rilevanza travel/hospitality, modello B2B e orientamento verso API/integration/infrastructure. L'output è segment, fit_score, reason e next_action.
Langfuse nel progetto serve a:
- tracciare le chiamate e vedere input/output;
- gestire e versionare i prompt;
- mantenere un dataset di benchmark;
- eseguire esperimenti sulle diverse versioni;
- applicare evaluator automatici;
- confrontare quantitativamente una versione del prompt con un'altra. GitHub
Per esempio nel repository ci sono evaluator come:
segment_accuracy
score_range_consistency
reason_word_limit
reason_quality
e il confronto tra prompt v1 e v2 mostra che entrambi rispettano perfettamente i vincoli funzionali, mentre la qualità del reasoning passa da 0,500 a 0,550.
Quindi quale problema risolve Langfuse?
Non:
“ho dei lead e Langfuse mi dice quali sono buoni”.
Piuttosto:
“ho inserito un LLM dentro un processo GTM: come faccio a sapere cosa sta facendo, se è stabile, se una modifica al prompt lo migliora e se continua a rispettare le regole di business?”
Cosa ho costruito
AZIENDA
↓
DATI / SEGNALI
↓
REGOLE DETERMINISTICHE
├─ segmento
└─ next action
↓
LLM
├─ fit score
└─ reasoning
↓
OUTPUT
LANGFUSE
┌─────────────────┐
│ tracing │
│ prompt versions │
LLM ──▶│ dataset │
│ experiments │
│ evaluations │
└─────────────────┘
Scelte di engineering
- Architettura ibrida deterministico + LLM: il codice determina i tre segnali principali — travel/hospitality, B2B, API/infrastructure — e da lì assegna
segmentenext_action. L’LLM non decide quindi le regole di business stabili; produce solofit_scoree reasoning qualitativo. È stata una scelta esplicita per ridurre la variabilità osservata nelle prime versioni. - Node.js + JavaScript ES Modules come runtime leggero, senza framework applicativo pesante. Lo stack dichiarato include Node.js, OpenAI API, Langfuse, OpenTelemetry, JSON Schema e Git/GitHub.
- OpenAI come layer probabilistico controllato: il codice usa
gpt-4o-minicontemperature: 0, quindi punta a ridurre la variabilità dove il modello viene effettivamente usato. - Structured output via JSON Schema: la risposta LLM è vincolata a uno schema strict con soli
fit_scoreereason,additionalProperties: false. Questo evita output testuali liberi e rende il risultato direttamente utilizzabile dal codice. - Prompt management esterno al codice: il prompt
gtm-lead-qualifierviene recuperato da Langfuse con labelproductione poi compilato a runtime. Quindi il prompt può essere versionato e modificato senza hardcodarlo nell’applicazione. - Tracing tramite OpenTelemetry + Langfuse: viene inizializzato il
NodeSDKconLangfuseSpanProcessore il client OpenAI viene wrappato conobserveOpenAI. In pratica le chiamate LLM diventano osservabili invece di essere una black box. - Dataset di benchmark separato: le aziende di test vengono lette da
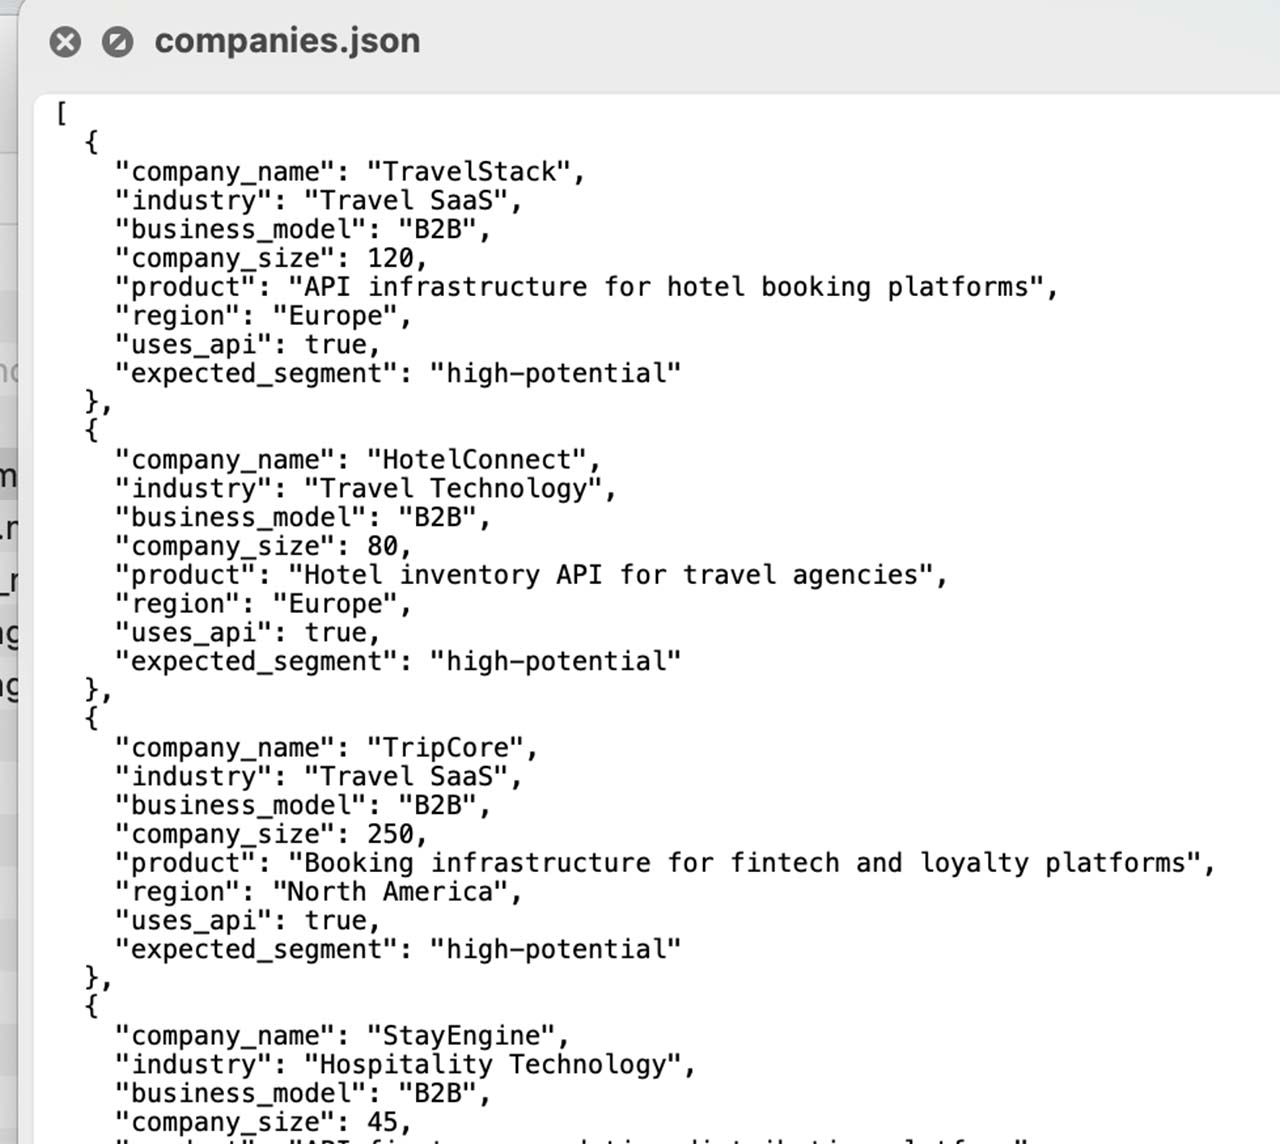
data/companies.json; il benchmark dichiarato contiene 15 aziende simulate. Questo permette di separare logica applicativa e test set.
Risultato
Nel benchmark V3 il workflow ha ottenuto 15 classificazioni corrette su 15. Il risultato principale e la separazione tra business rules deterministiche e reasoning probabilistico.