Un sistema che allinea fonti esterne e dati proprietari per generare automaticamente schede giocatore con foto, ranking, storico e previsioni.
Il problema
La produzione delle schede giocatore richiedeva troppo lavoro manuale. Per ogni calciatore bisognava raccogliere informazioni da fonti diverse, ricondurle alla stessa identità, verificare i dati utili, costruire ranking e previsioni, recuperare immagini e poi trasformare tutto in una scheda editoriale coerente.
Il collo di bottiglia non era quindi “scrivere un testo”, ma assemblare fonti eterogenee in un output affidabile e pubblicabile.
Una scheda richiedeva mediamente 15–20 minuti; su centinaia di giocatori il processo non scalava.
La soluzione
Abbiamo costruito una pipeline che separa nettamente raccolta dati, normalizzazione e generazione editoriale.
Il flusso è concettualmente:
Fonti calcistiche
↓
Entity matching giocatore
↓
Normalizzazione dati
↓
Enrichment
↓
Ranking + statistiche + previsioni
↓
Contesto strutturato
↓
LLM
↓
Scheda editoriale completa
Cosa ho costruito
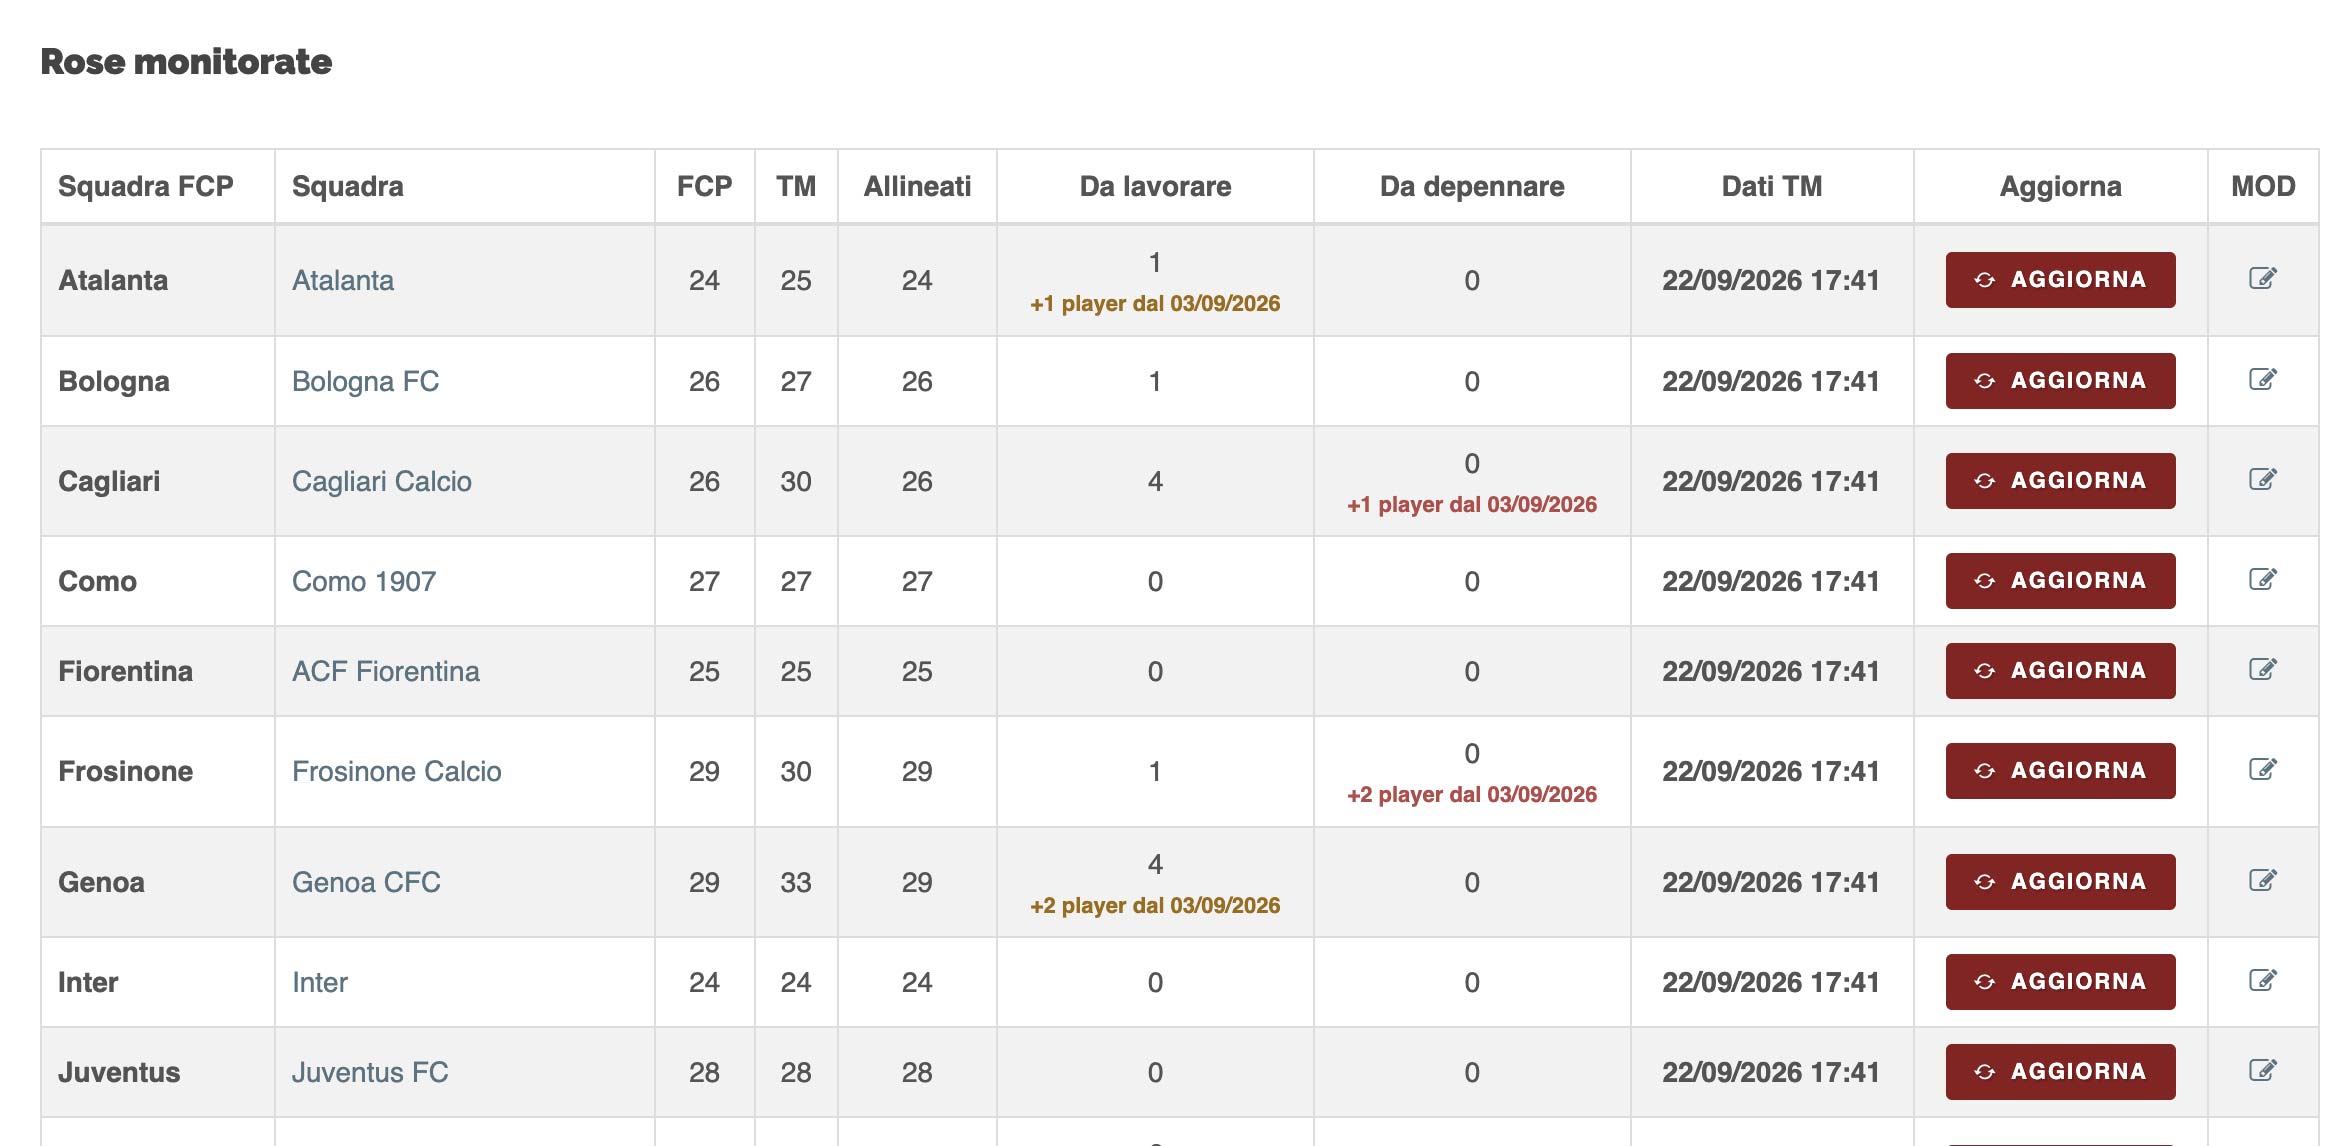
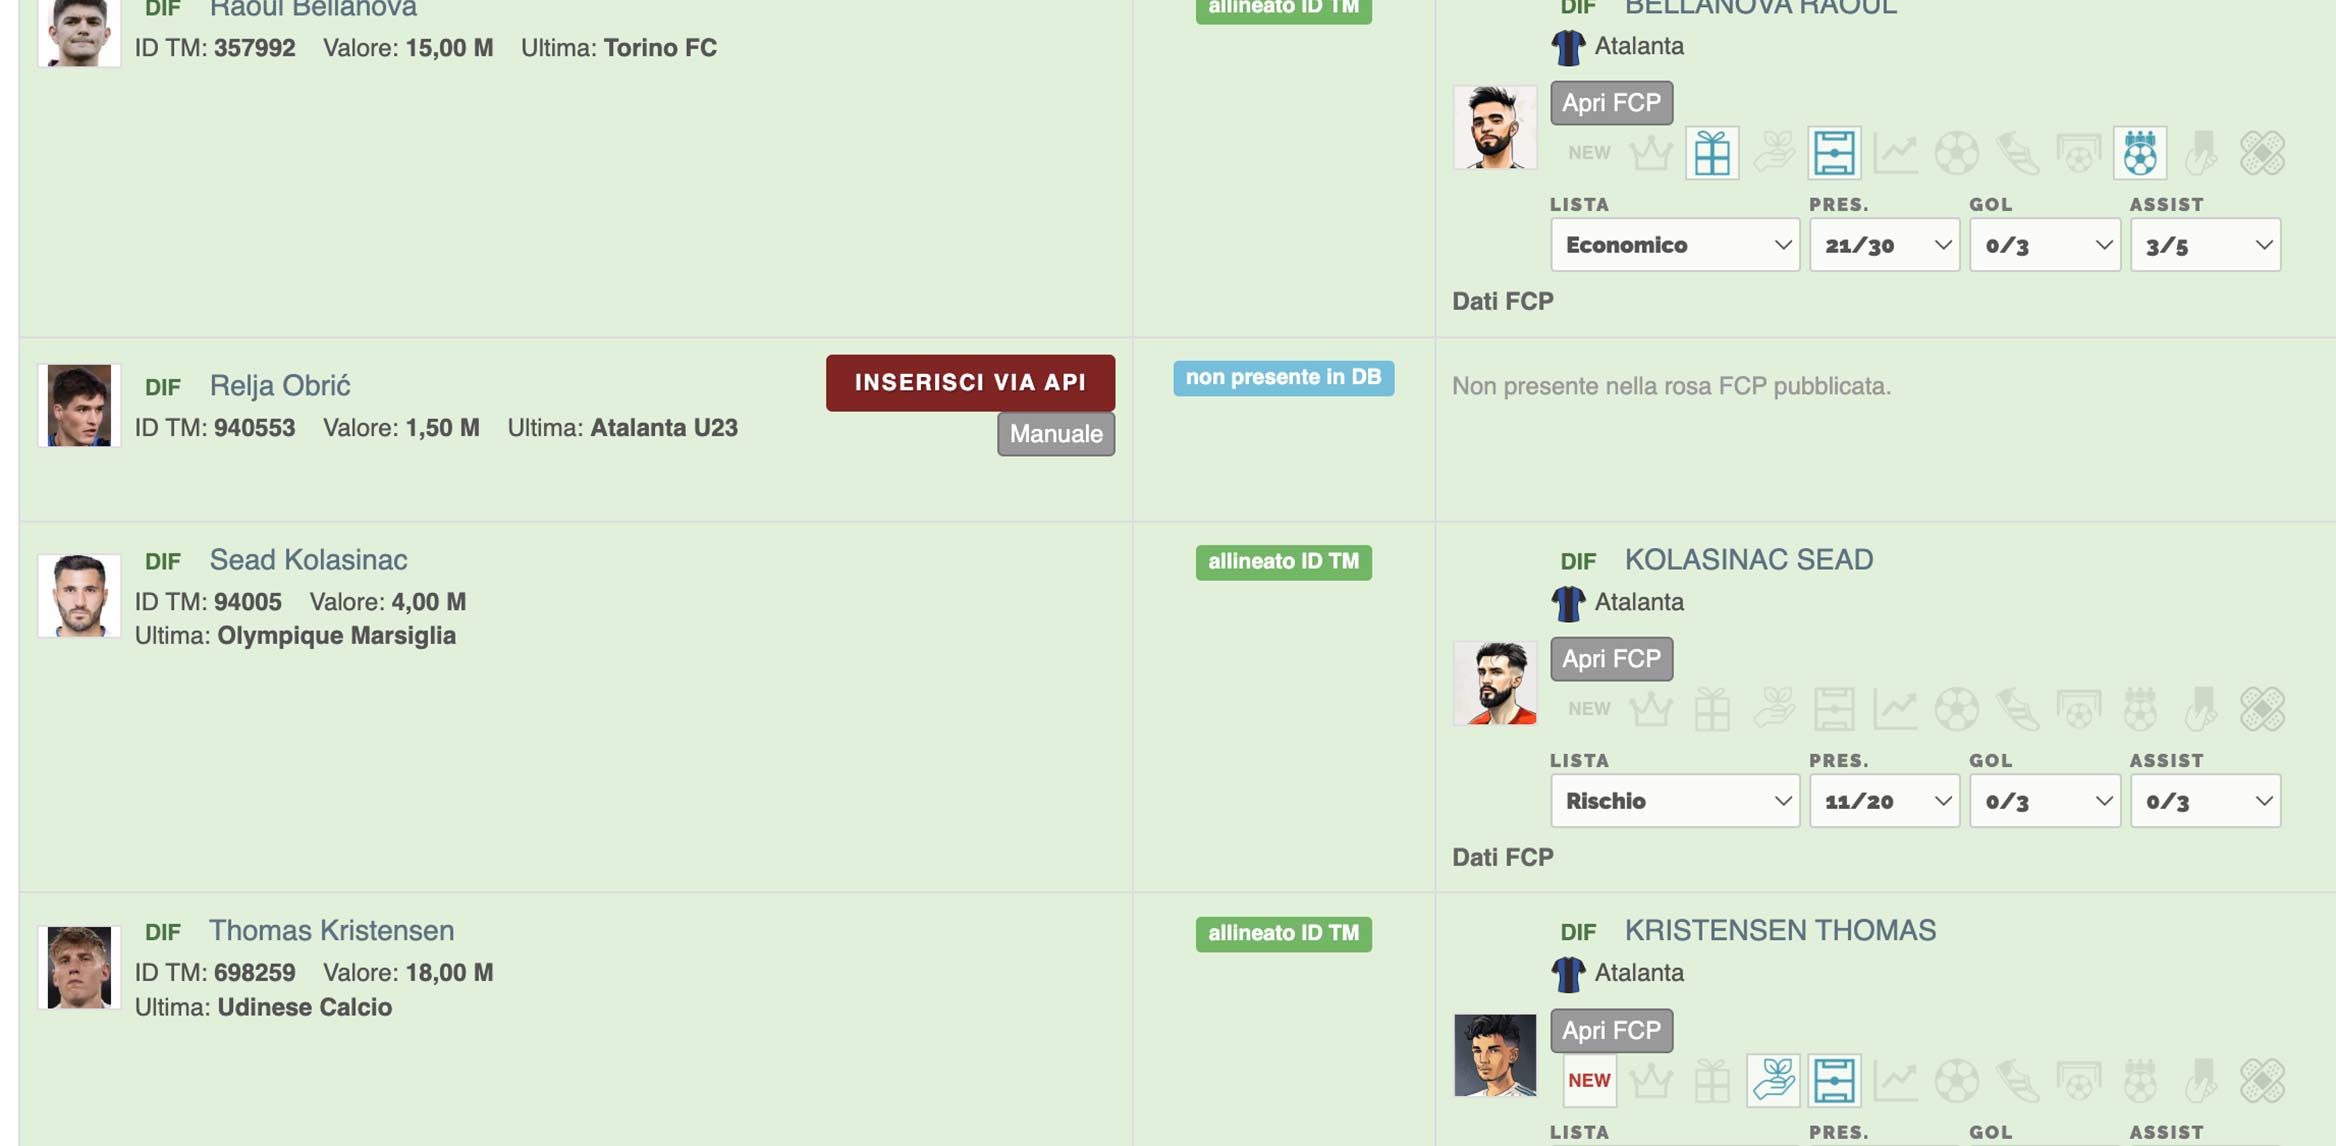
Il sistema allinea il giocatore tra le fonti disponibili, costruisce un contesto strutturato e solo dopo affida all'LLM la generazione della scheda.
Cosa cambia:
15–20 minuti → 15–30 secondi per giocatore.
Scelte di engineering
1. Separazione tra dati e generazione
L'LLM non viene usato per inventare statistiche o ricostruire il dato calcistico.
2. Entity matching
Fonte A ─┐
Fonte B ─┼──> PLAYER ENTITY
Fonte C ─┘
3. Enrichment progressivo
La pipeline non usa una singola sorgente come verità assoluta.
4. LLM usato come editorial layer
Il modello interviene principalmente per:
- sintetizzare;
- organizzare;
- trasformare i dati in linguaggio editoriale;
- mantenere struttura e tono coerenti;
- produrre una scheda pronta per il CMS.
Quindi:
LLM ≠ database calcistico
ma:
LLM = presentation / reasoning layer sui dati preparati.
5. Automazione end-to-end
L'obiettivo non era creare un assistente che “aiutasse il redattore”. Era eliminare quasi completamente la sequenza manuale
6. Stack applicativo
Per il portfolio lo sintetizzerei così:
PHP · MySQL · APIs · Data retrieval · Entity matching · LLM · Structured generation
Risultato
Non abbiamo automatizzato la scrittura. Abbiamo automatizzato tutto ciò che deve accadere prima che la scrittura possa essere affidabile.