Dal completamento delle frasi alla gestione dei processi: cosa è successo dal 2022, dove siamo arrivati e perché conterà sempre meno il modello e sempre più il sistema che gli costruiamo intorno.
Marketing Engineer. Lavoro nel punto d’incontro tra marketing, software, dati e intelligenza artificiale.
SELECTED BUILDS
2022: quando i modelli AI escono dai laboratori
Il 2022 non è l’anno in cui nascono i grandi modelli linguistici, ma è l’anno in cui smettono di essere materia quasi esclusiva da paper, laboratori e API per sviluppatori. Il 30 novembre OpenAI pubblica ChatGPT come research preview: un’interfaccia conversazionale costruita su una famiglia di modelli già addestrati a seguire istruzioni e raffinati con feedback umano. La vera novità non è quindi una singola invenzione improvvisa, ma l’incontro tra capacità già maturate, post-training orientato al comportamento e una forma d’uso semplicissima: scrivere una domanda e ricevere una risposta.
Da quel momento milioni di persone iniziano a confrontarsi direttamente con una macchina capace non solo di completare testo, ma di sostenere un dialogo, correggere codice, riassumere, tradurre, spiegare e adattarsi al contesto della conversazione. È qui che cambia la percezione pubblica dell’intelligenza artificiale: da tecnologia specialistica a interlocutore general purpose.
Prima degli LLM: backpropagation, Transformer e previsione del token successivo
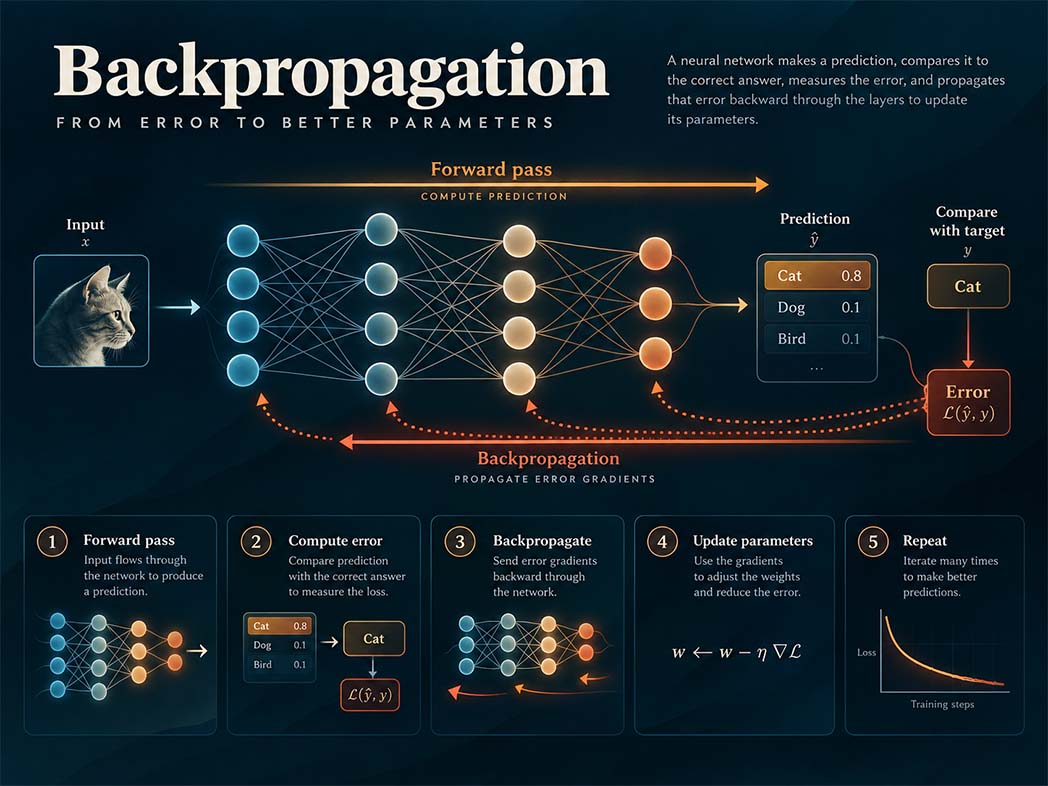
Per capire cosa fanno davvero i modelli linguistici bisogna partire da un punto spesso frainteso: non vengono programmati inserendo al loro interno regole, concetti e risposte una per una. Durante l’addestramento ricevono enormi quantità di testo e provano continuamente a prevedere quale elemento dovrebbe venire dopo. Quando sbagliano, un meccanismo chiamato backpropagation misura l’errore e lo propaga all’indietro attraverso la rete, modificando progressivamente i parametri del modello. Ripetuto miliardi di volte, questo processo fa emergere una rete di relazioni statistiche sempre più sofisticate tra parole, strutture linguistiche, fatti e concetti.
Il salto decisivo arriva nel 2017 con l’architettura Transformer. Il suo meccanismo di attention permette al modello di valutare quali parti di una sequenza siano più rilevanti per interpretarne le altre, lavorando sulle relazioni tra gli elementi del testo in modo molto più efficace rispetto alle architetture precedenti. È su questa base che nascono i moderni Large Language Models.
Alla radice, però, l’operazione resta sorprendentemente semplice: dato un contesto, il modello calcola una distribuzione di probabilità sui possibili token successivi — frammenti di parole, parole o simboli — e ne seleziona uno. Poi ripete l’operazione sul nuovo contesto.
“Parigi è la capitale della …”

Francia      0,94
Germania     0,02
città        0,01
Europa       0,01
...
Da qui nasce uno dei grandi paradossi degli LLM: un meccanismo apparentemente così elementare riesce a produrre comportamenti che sembrano molto meno elementari. Se tutto ciò che fanno è prevedere il token successivo, come possono tradurre, programmare, risolvere problemi, riconoscere analogie o costruire spiegazioni? È proprio questa domanda che, negli anni successivi, renderà sempre meno soddisfacente descriverli semplicemente come macchine che “indovinano la parola successiva”.
Il “pappagallo stocastico”: una critica importante che oggi non basta più
Nel 2021 Emily Bender, Timnit Gebru e altri ricercatori usarono l’espressione “stochastic parrots”, pappagalli stocastici, per descrivere il rischio di attribuire comprensione a sistemi che generano linguaggio combinando pattern appresi da enormi quantità di testo. La metafora era efficace: un modello può produrre frasi plausibili, perfino brillanti, senza necessariamente possedere del mondo la stessa comprensione che attribuiamo a un essere umano.
Il punto rimane valido. Un LLM non verifica automaticamente che ciò che sta dicendo sia vero, non possiede esperienza diretta del mondo e può produrre una frase perfettamente coerente anche quando parte da una premessa falsa. La fluidità del linguaggio, da sola, non dimostra comprensione. Ed è proprio questa distanza tra plausibilità linguistica e verità a spiegare molti dei fenomeni che abbiamo imparato a chiamare hallucinations.
Il problema nasce quando la metafora viene presa alla lettera e trasformata in una descrizione completa del funzionamento dei modelli. Dire che un LLM “si limita a ripetere ciò che ha visto” non spiega bene la sua capacità di applicare una regola a esempi nuovi, tradurre tra rappresentazioni diverse, scrivere codice mai incontrato in quella forma, costruire analogie o combinare informazioni in modi che non corrispondono a una semplice copia del training set. Predire il token successivo è l’obiettivo dell’addestramento; non significa necessariamente che il modello risolva quel compito attraverso una gigantesca collezione di frasi memorizzate.
Per prevedere bene il linguaggio, infatti, diventa utile imparare qualcosa della struttura che lo genera. Se in miliardi di testi “Roma” compare in relazione a Italia, città, capitale, storia, geografia, impero, Lazio e migliaia di altri concetti, il modello non conserva necessariamente una voce di dizionario chiamata Roma. Durante l’addestramento costruisce invece configurazioni interne capaci di rappresentare quelle relazioni e di riutilizzarle in contesti diversi.
Questo non risolve la questione filosofica della comprensione, né rende un LLM equivalente a una mente umana. Ma sposta la domanda in un territorio molto più interessante: che cosa si forma realmente dentro una rete neurale quando impara a prevedere il linguaggio così bene?
Negli ultimi anni, la ricerca sull’interpretabilità ha iniziato a mostrarci qualche indizio. E ciò che emerge assomiglia meno a un archivio di frasi e molto di più a un enorme spazio di feature, rappresentazioni e combinazioni di attivazioni. Una sorta di alfabeto interno che non abbiamo progettato noi e che stiamo solo iniziando a decifrare.
L’alfabeto nascosto degli LLM: neuroni, feature e “accordi” concettuali
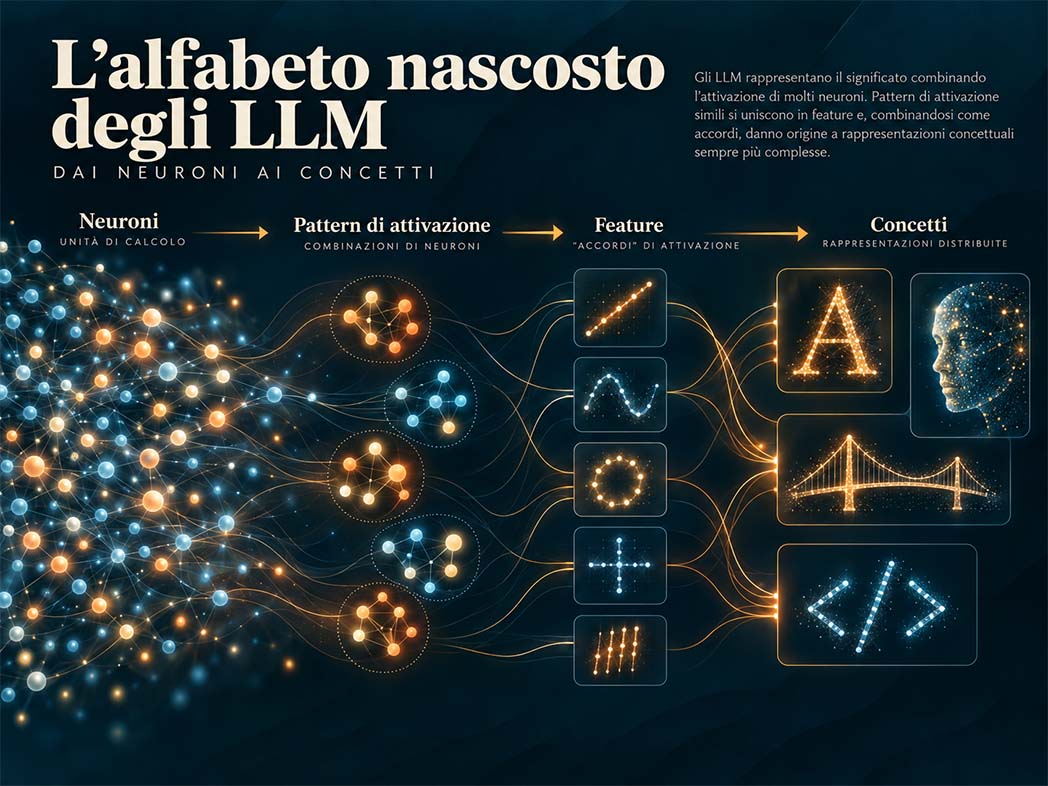
Se i modelli non si limitano a conservare frasi già viste, allora dove finiscono i concetti? La risposta più interessante arriva oggi dalla ricerca sull’interpretabilità meccanicistica: non sembra esistere, in generale, un singolo neurone per un singolo concetto. I modelli distribuiscono l’informazione su molti neuroni contemporaneamente, e gli stessi neuroni possono contribuire a rappresentazioni diverse. Per questo guardare un neurone isolato spesso dice molto poco. Anthropic
Negli ultimi anni i ricercatori hanno iniziato a estrarre da queste attivazioni delle strutture più leggibili, chiamate feature: pattern ricorrenti di attività neurale che possono corrispondere a entità, proprietà o concetti relativamente interpretabili. Anthropic, studiando Claude 3 Sonnet, ha individuato milioni di queste feature: alcune associate a luoghi come il Golden Gate Bridge, altre a persone, elementi chimici, errori nel codice, segreti, conflitti interiori e concetti molto più astratti. OpenAI ha condotto ricerche analoghe su GPT-4, decomponendone le rappresentazioni interne in milioni di pattern spesso interpretabili. Anthropic
Un modo intuitivo per immaginarle è pensare a una specie di alfabeto interno. Ma forse la metafora ancora migliore è musicale. Un singolo neurone è come una nota: preso da solo può significare poco. È la combinazione di più attivazioni a produrre qualcosa di riconoscibile. Potremmo chiamare queste configurazioni “accordi neurali”: insiemi di attivazioni che, quando ricorrono insieme, contribuiscono a rappresentare un certo concetto.
neuroni
  ↓
pattern di attivazione
  ↓
feature
  ↓
combinazioni di feature
  ↓
rappresentazioni concettuali
La parte sorprendente è che queste rappresentazioni non sembrano essere semplici etichette linguistiche. La stessa feature può attivarsi davanti al nome di un oggetto in lingue diverse, alla sua descrizione e perfino a un’immagine che lo rappresenta. Nel caso del Golden Gate Bridge, per esempio, Anthropic ha osservato una feature sensibile al concetto del ponte attraverso testi in più lingue e immagini. Inoltre, feature concettualmente vicine tendono a trovarsi vicine anche nello spazio interno del modello: intorno al Golden Gate compaiono, tra gli altri, Alcatraz, San Francisco, il terremoto del 1906 e Vertigo. Anthropic
Ancora più importante, queste feature non sembrano essere soltanto correlazioni osservate dall’esterno. I ricercatori sono riusciti a modificarne artificialmente l’intensità e a provocare cambiamenti coerenti nel comportamento del modello. Aumentando fortemente la feature del Golden Gate Bridge, Claude iniziava a riportare il ponte praticamente ovunque, anche quando non aveva alcuna relazione con la domanda. Questo suggerisce che almeno alcune feature abbiano un ruolo causale nel modo in cui il modello elabora e utilizza i concetti. Anthropic
Siamo però ancora molto lontani dall’avere un dizionario completo della “mente” di un LLM. Le tecniche attuali recuperano solo una parte delle rappresentazioni presenti, sono costose e non spiegano ancora come le feature si combinino nei circuiti che producono un ragionamento o una risposta. Ma il quadro che emerge è già sufficiente a complicare molto l’immagine del pappagallo stocastico: il modello non conserva semplicemente frasi; costruisce rappresentazioni interne che sembrano organizzare il significato in forme riutilizzabili.
E questo apre una conseguenza fondamentale: se una parte della conoscenza è incorporata nei parametri del modello, non significa che tutta la conoscenza utile debba esserlo. Da qui nasce una delle trasformazioni architetturali più importanti degli ultimi anni: il RAG, cioè la possibilità di portare conoscenza esterna dentro il contesto del modello proprio nel momento in cui serve.
Dal sapere nei pesi al sapere fuori dal modello: l’arrivo del RAG
Uno dei limiti più evidenti dei grandi modelli linguistici è che una parte enorme della loro conoscenza è incorporata nei pesi, cioè nei parametri appresi durante l’addestramento. Questo significa che il modello può “sapere” molte cose, ma non può aggiornare facilmente quella conoscenza ogni volta che il mondo cambia. Se un’informazione non era presente nel training, oppure è diventata obsoleta, il modello non ha automaticamente accesso alla versione corretta.
È qui che entra in gioco il Retrieval-Augmented Generation, o RAG. Il termine viene formalizzato nel 2020 da Patrick Lewis e altri ricercatori in un lavoro che propone di combinare due forme di memoria: una parametrica, contenuta nel modello, e una non parametrica, costituita da documenti esterni recuperati al momento della richiesta. L’idea è semplice ma potentissima: invece di pretendere che il modello ricordi tutto, gli si forniscono le informazioni rilevanti proprio quando deve rispondere. papers.nips.cc
senza RAG

domanda
   ↓
LLM
   ↓
conoscenza nei parametri
   ↓
risposta
con RAG

domanda
   ↓
retrieval
   ↓
documenti rilevanti
   ↓
contesto
   ↓
LLM
   ↓
risposta
La trasformazione è più importante di quanto sembri. Con il RAG possiamo aggiornare una base documentale senza riaddestrare il modello, lavorare su informazioni private o proprietarie e, almeno in parte, ricostruire da dove arriva una risposta. Già il lavoro originale sottolineava che i modelli puramente parametrici hanno difficoltà ad aggiornare la propria conoscenza e a fornire una provenienza verificabile delle informazioni, mentre l’accesso a una memoria esterna rende il sistema più modulare e ispezionabile. papers.nips.cc
Questo però non significa che il RAG elimini automaticamente le allucinazioni. Il sistema può recuperare il documento sbagliato, interpretarlo male, ignorare un passaggio importante o generare comunque una conclusione non supportata dalle fonti. Il problema non scompare: si sposta dall’avere un solo modello al progettare correttamente una pipeline composta da retrieval, selezione del contesto e generazione.
Ed è proprio qui che cambia il modo di pensare agli LLM. Il modello smette progressivamente di essere considerato un contenitore autosufficiente di conoscenza e diventa il componente di un sistema più ampio. Alcune informazioni stanno nei suoi pesi, altre arrivano da database, documenti, API o motori di ricerca. La domanda non è più soltanto:
“Quanto sa questo modello?”
ma sempre più:
“A quali informazioni può accedere nel momento in cui deve ragionare?”
È uno dei primi passaggi decisivi dal modello come prodotto al modello come parte di un’architettura.
Addestrare una capacità non significa decidere un comportamento
A questo punto emerge una distinzione fondamentale: insegnare a un modello a rappresentare il linguaggio non equivale a decidere come dovrà comportarsi quando qualcuno inizierà a usarlo.
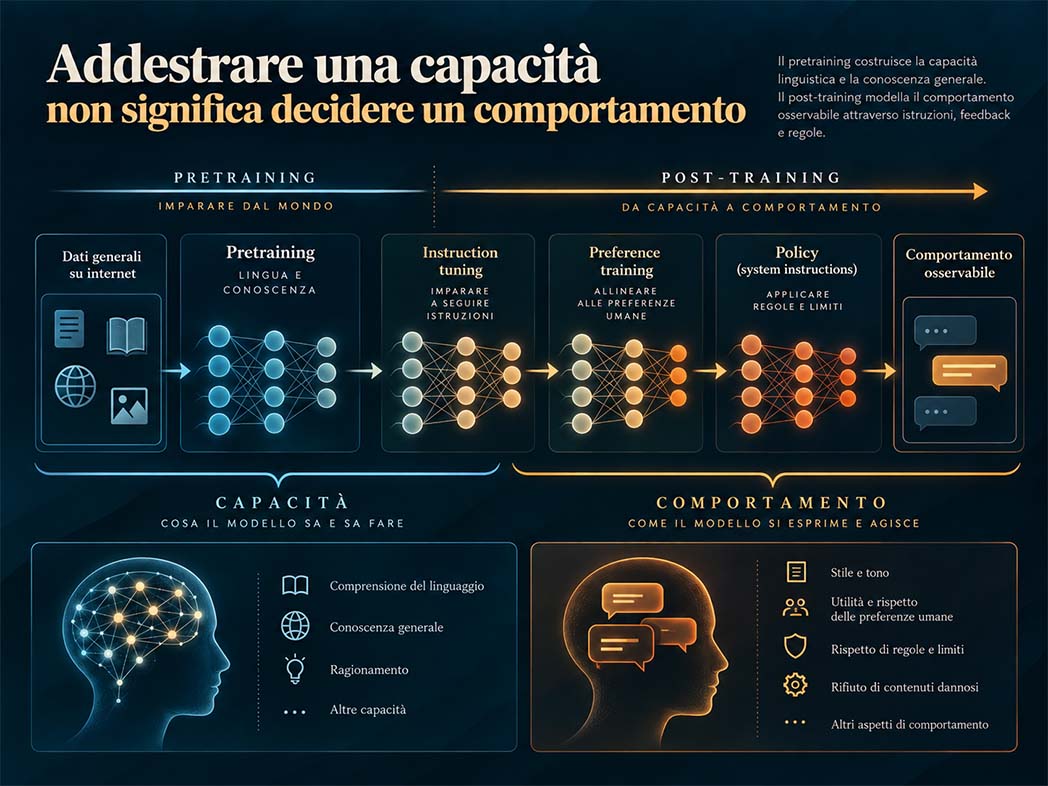
Il pretraining costruisce la base generale. Il modello viene esposto a enormi quantità di testo e impara regolarità linguistiche, relazioni tra concetti, strutture argomentative, forme di conoscenza e pattern di ragionamento. Ma un modello preaddestrato, da solo, non è necessariamente un buon assistente: può completare una frase, imitare uno stile, proseguire un dialogo, ma non ha ancora imparato in modo stabile che dovrebbe seguire un’istruzione, rifiutare una richiesta pericolosa, ammettere un’incertezza o privilegiare una risposta utile rispetto a una semplicemente plausibile.
È qui che entra in gioco il post-training. Dopo aver costruito le capacità generali, il modello viene ulteriormente addestrato per trasformarle in un comportamento più controllabile e coerente con l’uso previsto.
In forma semplificata:
PRETRAINING
impara il linguaggio, le relazioni e le rappresentazioni

        ↓

INSTRUCTION TUNING
impara a seguire richieste e formati

        ↓

PREFERENCE TRAINING
impara quali risposte vengono considerate migliori

        ↓

POLICY / SYSTEM INSTRUCTIONS
riceve vincoli, priorità e regole operative

        ↓

COMPORTAMENTO OSSERVABILE
Una delle tecniche che ha segnato questa fase è il Reinforcement Learning from Human Feedback, o RLHF. Invece di limitarsi a mostrare al modello esempi corretti, si raccolgono preferenze umane tra risposte alternative e si usa quel segnale per orientare il modello verso comportamenti ritenuti più utili, pertinenti o sicuri. Negli anni successivi sono emerse anche varianti che usano feedback generato da altri modelli, critiche automatiche e rubriche più strutturate.
Questo passaggio è importante perché separa due domande che spesso vengono confuse:
Che cosa è capace di fare il modello?
e
Come vogliamo che scelga di usare quelle capacità?
Un modello può possedere la capacità tecnica di produrre codice, persuadere, classificare, pianificare o sintetizzare informazioni. Ma resta da stabilire quando dovrebbe farlo, con quali limiti, secondo quali priorità e come dovrebbe comportarsi nei casi ambigui.
Più i modelli diventano capaci, meno è realistico descriverne il comportamento attraverso una semplice lista di divieti. Se un sistema deve operare in situazioni nuove, usare strumenti, confrontare obiettivi in conflitto o prendere decisioni intermedie, non possiamo prevedere in anticipo ogni possibile circostanza.
Il problema comincia allora ad assomigliare meno alla programmazione tradizionale:
se succede A → fai B
e sempre più alla definizione di un insieme di principi:
quando A, B e C entrano in conflitto
→ valuta priorità, contesto e conseguenze
→ scegli il comportamento più coerente
È proprio da questa esigenza che nasce uno degli esperimenti più interessanti nell’evoluzione recente degli LLM: invece di limitarsi a dire a un modello cosa non deve fare, provare a dargli una sorta di costituzione, un insieme di principi con cui orientarsi anche quando la regola specifica non esiste.
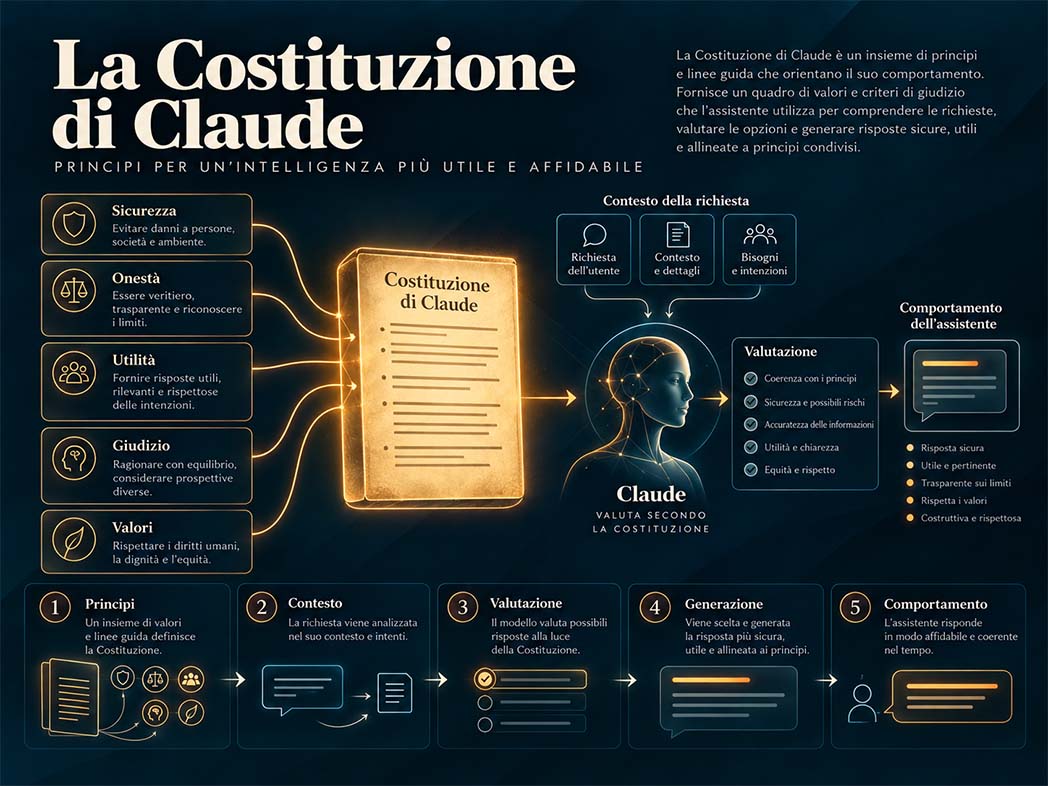
La Costituzione di Claude: che tipo di macchina vogliamo costruire?
Nel gennaio 2026 Anthropic ha pubblicato una nuova versione della Claude’s Constitution, un documento che descrive in modo esplicito i valori, le priorità e il comportamento che l’azienda vuole incorporare nei propri modelli. Non è soltanto una policy destinata agli utenti: Anthropic la presenta come una parte importante del processo di training, capace di influenzare direttamente il comportamento di Claude. Anthropic
L’idea nasce dalla Constitutional AI, una linea di ricerca che Anthropic porta avanti almeno dal 2022-2023: invece di affidarsi soltanto a feedback umani su migliaia di singole risposte, si forniscono al modello principi generali scritti in linguaggio naturale e lo si addestra anche a criticare e revisionare le proprie risposte alla luce di quei principi. In altre parole, si prova a spostare una parte dell’allineamento da una lunga collezione di esempi specifici a una struttura normativa più generale. Anthropic
La nuova costituzione è interessante soprattutto per come è scritta. Anthropic dice esplicitamente che il suo pubblico principale è Claude stesso. Il documento parla quindi al modello usando concetti che normalmente riserveremmo alle persone: virtù, saggezza, onestà, giudizio, valori. L’obiettivo dichiarato non è costruire una lista infinita di istruzioni del tipo “se succede X, fai Y”, ma fornire un quadro sufficientemente generale da permettere al modello di orientarsi anche nei casi che gli sviluppatori non hanno previsto in anticipo. Anthropic
In estrema sintesi, la costituzione stabilisce una gerarchia di priorità: Claude dovrebbe essere sicuro, etico, rispettare le linee guida specifiche di Anthropic e, all’interno di questi vincoli, essere realmente utile alle persone con cui interagisce. Ma il punto più interessante non è l’elenco dei valori. È il tentativo di insegnare al modello come risolvere i conflitti tra quei valori.
regola tradizionale

SE richiesta = X
→ risposta = Y
approccio costituzionale

principi
   ↓
contesto
   ↓
possibile conflitto tra valori
   ↓
valutazione
   ↓
comportamento
È un cambiamento sottile ma importante. Più un modello diventa capace di lavorare in ambienti aperti, utilizzare strumenti e prendere decisioni intermedie, meno possiamo sperare di anticipare con una regola ogni situazione futura. La sua affidabilità dipenderà anche dalla capacità di generalizzare principi a circostanze nuove.
Naturalmente, chiamarlo “Costituzione” non significa che Claude possieda una morale autonoma o che il documento funzioni come una costituzione politica. Anthropic stessa precisa che non intende il termine come un insieme rigido di norme da applicare meccanicamente, ma come una struttura fondativa che dovrebbe orientare il carattere e il comportamento del sistema. È inoltre un progetto dichiaratamente incompleto: il fatto che un principio sia scritto nella costituzione non garantisce che il modello lo applichi sempre correttamente. Anthropic
Eppure il documento segna bene il punto a cui siamo arrivati. Nel giro di pochi anni siamo passati dal chiederci come far completare correttamente una frase a una rete neurale al chiederci quali principi dovrebbe utilizzare quella stessa rete quando deve agire in situazioni che non abbiamo previsto.
Ed è una domanda destinata a diventare ancora più importante, perché nel frattempo i modelli non sono semplicemente diventati più grandi: sono cambiate profondamente anche le cose che siamo in grado di chiedere loro di fare.
Che cosa è realmente migliorato nei modelli AI dal 2022 a oggi
Se guardiamo soltanto alle classifiche dei modelli, gli ultimi quattro anni sembrano una successione di nomi, versioni e benchmark. GPT, Claude, Gemini, Llama, DeepSeek e decine di altri modelli si sono alternati rapidamente ai vertici. Ma questa cronaca rischia di nascondere la trasformazione più importante: non è migliorata una sola capacità. È cambiato il perimetro di ciò che un modello può fare all’interno di un sistema software.
Nel 2022 l’esperienza tipica era ancora essenzialmente questa:
testo
  ↓
modello
  ↓
testo
Oggi un modello può ricevere testo, immagini, audio e documenti, mantenere contesti molto più estesi, produrre dati strutturati, utilizzare strumenti esterni, interrogare database e API, scrivere ed eseguire codice e affrontare problemi composti da più passaggi. I modelli di reasoning, in particolare, introducono computazione aggiuntiva prima della risposta per pianificare, confrontare alternative, utilizzare tool e affrontare compiti multi-step più difficili. OpenAI Developers
Le trasformazioni principali possono essere ricondotte ad alcune direzioni.
-
Più contesto. Le finestre di contesto sono cresciute enormemente rispetto ai primi chatbot. Questo permette di lavorare su repository, raccolte di documenti, conversazioni lunghe e quantità di informazioni che prima avrebbero richiesto una frammentazione manuale. Avere più spazio, naturalmente, non significa automaticamente saperlo utilizzare bene: selezione e organizzazione del contesto restano un problema progettuale.
-
Multimodalità. Il confine tra “language model” e altri modelli si è fatto sempre meno netto. Testo, immagini, audio e video possono entrare nello stesso flusso di elaborazione. Anche il retrieval sta diventando multimodale: non recuperiamo più soltanto paragrafi di testo, ma possiamo cercare informazioni dentro immagini e documenti complessi. blog.google
-
Reasoning più lungo. Una delle evoluzioni più significative è stata destinare più calcolo al momento dell’inferenza. Invece di generare immediatamente una risposta, alcuni modelli possono dedicare risorse aggiuntive all’analisi del problema, alla pianificazione e alla verifica di strade alternative. Questo ha migliorato soprattutto matematica, coding, scienza e attività composte da molti passaggi. OpenAI Developers
-
Tool use. Il modello non deve più necessariamente contenere o calcolare tutto internamente. Può decidere di chiamare una funzione, interrogare un database, eseguire una ricerca o invocare un servizio esterno. È una trasformazione fondamentale: l’LLM passa dall’essere un generatore di output a diventare un possibile orchestratore di capacità esterne.
-
Output strutturati. Nei primi sistemi basati su LLM era normale chiedere al modello di “rispondere in JSON” e sperare che rispettasse il formato. Oggi le API possono vincolare l’output a schemi precisi. Questo dettaglio apparentemente tecnico rende i modelli molto più integrabili nel software tradizionale: una risposta non è più soltanto testo da leggere, ma può diventare un oggetto affidabile che un’altra funzione utilizzerà. OpenAI Developers
-
Coding. La capacità di comprendere, modificare e produrre software è cresciuta rapidamente, fino a permettere ai modelli di lavorare su repository, diagnosticare problemi e portare avanti task che richiedono più file e più passaggi. I benchmark mostrano progressi molto forti in quest’area, anche se gli stessi benchmark diventano sempre più difficili da interpretare man mano che vengono saturati. Stanford HAI
-
Costo ed efficienza. Non sono migliorati soltanto i modelli più grandi. Capacità che pochi anni fa richiedevano sistemi costosi sono diventate disponibili in modelli più piccoli e molto meno onerosi. Lo Stanford AI Index ha documentato una caduta di oltre due ordini di grandezza nel costo necessario per raggiungere prestazioni paragonabili a GPT-3.5 tra il 2022 e il 2024. Stanford HAI
Il risultato è che anche il significato della parola “migliore” è diventato meno ovvio. I modelli di frontiera tendono in molte valutazioni ad avvicinarsi tra loro, mentre acquisiscono sempre più importanza fattori come costo, latenza, affidabilità, capacità di usare strumenti e prestazioni sullo specifico problema da risolvere. Lo Stanford AI Index 2026 rileva proprio una crescente convergenza nelle prestazioni dei modelli di punta e, contemporaneamente, una difficoltà sempre maggiore dei benchmark tradizionali nel misurare progressi che diventano rapidamente saturi. Stanford HAI
Questo non significa che i problemi fondamentali siano scomparsi. Le allucinazioni esistono ancora, la robustezza può cambiare enormemente da un compito all’altro e un modello molto performante su un benchmark può fallire in modo sorprendente quando cambiano leggermente le condizioni. Anche nel 2026 le valutazioni sull’affidabilità mostrano differenze importanti tra modelli e task. Stanford HAI
Ma proprio per questo il progresso più interessante non è semplicemente che il modello sa fare più cose. È che abbiamo imparato a distribuire il lavoro: memoria fuori dal modello, dati recuperati al momento giusto, regole espresse nel codice, strumenti esterni per agire, output strutturati per comunicare con altre applicazioni e modelli utilizzati soprattutto là dove servono interpretazione, generazione o ragionamento.
È qui che il vecchio problema del prompt perfetto comincia a diventare troppo piccolo. Se il comportamento dipende da quali informazioni entrano nel contesto, da quali strumenti sono disponibili, da ciò che il sistema ricorda e da ciò che recupera al momento opportuno, allora la vera disciplina emergente non consiste più soltanto nello scrivere bene un prompt.
Consiste nel progettare il contesto in cui il modello dovrà pensare e agire.
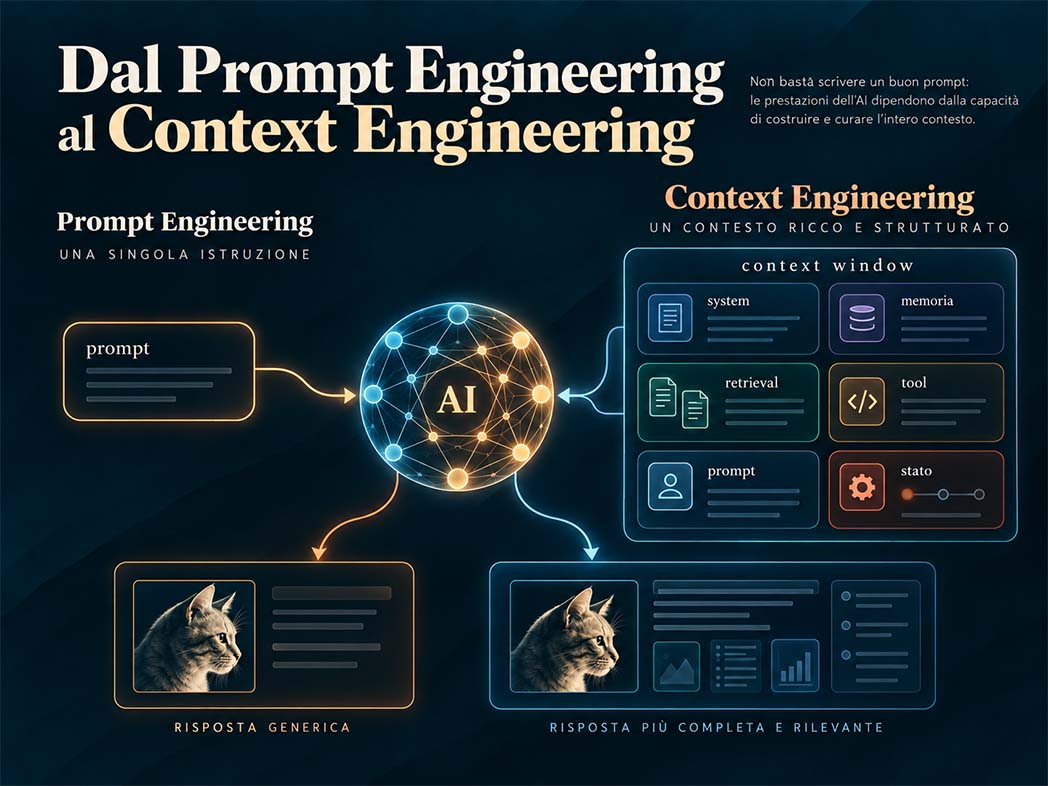
Dal Prompt Engineering al Context Engineering
Nei primi anni dell’AI generativa si è parlato moltissimo di prompt engineering: trovare la formulazione giusta, dare istruzioni precise, aggiungere esempi, imporre un formato, spiegare al modello il ruolo che doveva assumere. Era una disciplina quasi inevitabile quando l’interazione tipica consisteva in una singola richiesta seguita da una singola risposta.
Ma quando il modello entra in processi più lunghi, il prompt da solo non basta più. Un agente che lavora per minuti o ore accumula risultati di tool, documenti, conversazioni, stato, errori intermedi, decisioni prese in precedenza e nuove informazioni recuperate durante l’esecuzione. La domanda diventa quindi molto più ampia:
quale informazione deve avere il modello davanti, in questo preciso momento, per prendere la prossima decisione nel modo migliore?
È da qui che nasce il concetto di Context Engineering. Anthropic lo descrive come un’evoluzione naturale del prompt engineering: non si tratta più soltanto di scrivere bene le istruzioni, ma di progettare e mantenere l’insieme di informazioni che entrano nella context window durante l’inferenza — istruzioni di sistema, memoria, risultati dei tool, dati esterni, cronologia della conversazione e stato dell’applicazione. Anthropic
La differenza si può riassumere così:
PROMPT ENGINEERING

"Come devo formulare
questa istruzione?"
CONTEXT ENGINEERING

"Cosa deve sapere il modello adesso?
Cosa deve ricordare?
Cosa deve recuperare?
Quali tool deve vedere?
Cosa invece è meglio non mostrargli?"
Questo ultimo punto è importante. Più contesto non significa necessariamente più intelligenza. Riempire la finestra del modello con tutto ciò che abbiamo a disposizione può aumentare costo e latenza, introdurre informazioni contraddittorie e perfino peggiorare la qualità delle risposte. Nei sistemi agentici di lunga durata si parla ormai anche di context rot: man mano che cronologia, file e output dei tool si accumulano, il segnale utile rischia di essere sommerso dal rumore. LangChain
Per questo un buon sistema deve continuamente selezionare, comprimere, isolare e aggiornare il proprio contesto. Alcune informazioni possono restare nella conversazione corrente, altre diventare memoria persistente, altre essere recuperate solo quando servono tramite RAG o API, altre ancora possono essere affidate a un sub-agent e restituite al modello principale soltanto sotto forma di sintesi. LangChain riassume queste strategie in operazioni come write, select, compress, isolate: decidere cioè cosa conservare, cosa portare nel contesto e cosa tenere fuori. LangChain
Possiamo immaginare il contesto di un modello moderno in questo modo:
                 ┌─ system instructions
                 ├─ richiesta dell'utente
                 ├─ memoria
                 ├─ documenti recuperati
                 ├─ risultati delle API
                 ├─ tool disponibili
CONTEXT WINDOW ──┼─ stato del processo
                 ├─ esempi rilevanti
                 └─ cronologia utile
                        ↓
                       LLM
Il modello resta quello che genera la risposta o prende la decisione successiva, ma ciò che è in grado di fare dipende sempre di più dalla qualità del contesto che il sistema riesce a costruirgli attorno.
Ed è qui che il titolo di questo articolo comincia a prendere forma concreta. Due applicazioni possono utilizzare esattamente lo stesso modello e produrre risultati radicalmente diversi. Una può limitarsi a inviare un prompt. L’altra può fornirgli dati aggiornati, memoria, regole di business, strumenti, esempi, stato e meccanismi di verifica.
Il modello è lo stesso.
Il sistema no.
Il modello non è più l’applicazione
Per un certo periodo abbiamo parlato dei modelli AI quasi come se coincidessero con il prodotto. “Usa GPT”, “usa Claude”, “usa Gemini”: il nome del modello sembrava sufficiente a spiegare cosa facesse un’applicazione.
Oggi questa equivalenza funziona sempre meno.
Un sistema basato su AI può usare lo stesso identico modello di un altro e comportarsi in modo completamente diverso, perché ciò che conta non è soltanto il motore centrale, ma come viene inserito nell’architettura complessiva.
Un’applicazione moderna può includere:
                     ┌─ dati
                     ├─ memoria
                     ├─ RAG
                     ├─ regole di business
utente → sistema ────┼─ LLM
                     ├─ API e tool
                     ├─ validazioni
                     ├─ guardrail
                     ├─ eval
                     └─ observability
Il modello può interpretare una richiesta, classificare un caso ambiguo, generare una spiegazione o decidere quale strumento utilizzare. Ma molte altre parti del processo funzionano meglio quando vengono affidate a software tradizionale.
Se il prezzo di un prodotto è 39,90 euro, non c’è nessun motivo per chiedere a un LLM di “ricordarlo”: lo recuperiamo dal database. Se un cliente con stato unsubscribed non deve entrare in una campagna, quella è una regola deterministica, non una decisione da lasciare alla probabilità. Se dobbiamo conoscere la disponibilità di una camera, interroghiamo il PMS. Se dobbiamo capire il tono di un messaggio o sintetizzare venti recensioni, invece, un modello linguistico può essere lo strumento più adatto.
DATO CERTO                → database / API

REGOLA DI BUSINESS        → codice

CALCOLO                    → funzione

INFORMAZIONE AGGIORNATA   → retrieval

INTERPRETAZIONE            → LLM

SINTESI                    → LLM

AMBIGUITÀ                  → LLM

AZIONE                     → tool / API
Questa separazione è una delle lezioni più importanti degli ultimi anni: non tutto ciò che può essere fatto da un modello dovrebbe essere fatto da un modello.
Anzi, spesso un buon sistema AI usa l’intelligenza probabilistica soltanto nei punti in cui serve davvero, circondandola con componenti deterministiche che rendono il comportamento più stabile e verificabile.
È anche il motivo per cui stanno diventando centrali concetti come eval, tracing e observability. Se un’applicazione non produce più soltanto una risposta, ma effettua una sequenza di retrieval, decisioni, chiamate a tool e trasformazioni intermedie, controllare soltanto l’output finale non basta. Bisogna poter osservare il percorso che ha seguito, verificare dove ha sbagliato e misurare se una modifica al prompt, al modello o al contesto ha realmente migliorato il sistema.
Le piattaforme per agenti riflettono ormai esplicitamente questa architettura. Un agente viene definito non soltanto da un modello, ma dall’insieme di istruzioni, tool, guardrail, output strutturati, stato e possibilità di delegare ad altri agenti. Nei sistemi multi-agent, inoltre, si può decidere se un componente specializzato debba prendere temporaneamente il controllo oppure restare dietro le quinte come semplice capacità richiamata da un agente principale. OpenAI Developers
È una differenza concettuale enorme.
Nel paradigma iniziale:
modello → prodotto
Nel paradigma che sta emergendo:
modello → componente cognitivo di un sistema
E a questo punto la domanda “qual è il modello migliore?” comincia a perdere parte del suo significato. La domanda più utile diventa:
qual è il modello più adatto a questo compito, dentro questa architettura, con questi dati, questi strumenti e questi vincoli?
È qui che si capisce perché, paradossalmente, più i modelli diventano potenti, meno ha senso costruire tutto intorno al nome del modello.
Il passo successivo è quasi inevitabile. Se il modello può ricevere uno stato, scegliere strumenti, osservare il risultato delle proprie azioni e decidere cosa fare dopo, non stiamo più descrivendo soltanto un chatbot.
Stiamo iniziando a descrivere un agente.
Dai chatbot agli agenti: quando il modello entra nel processo
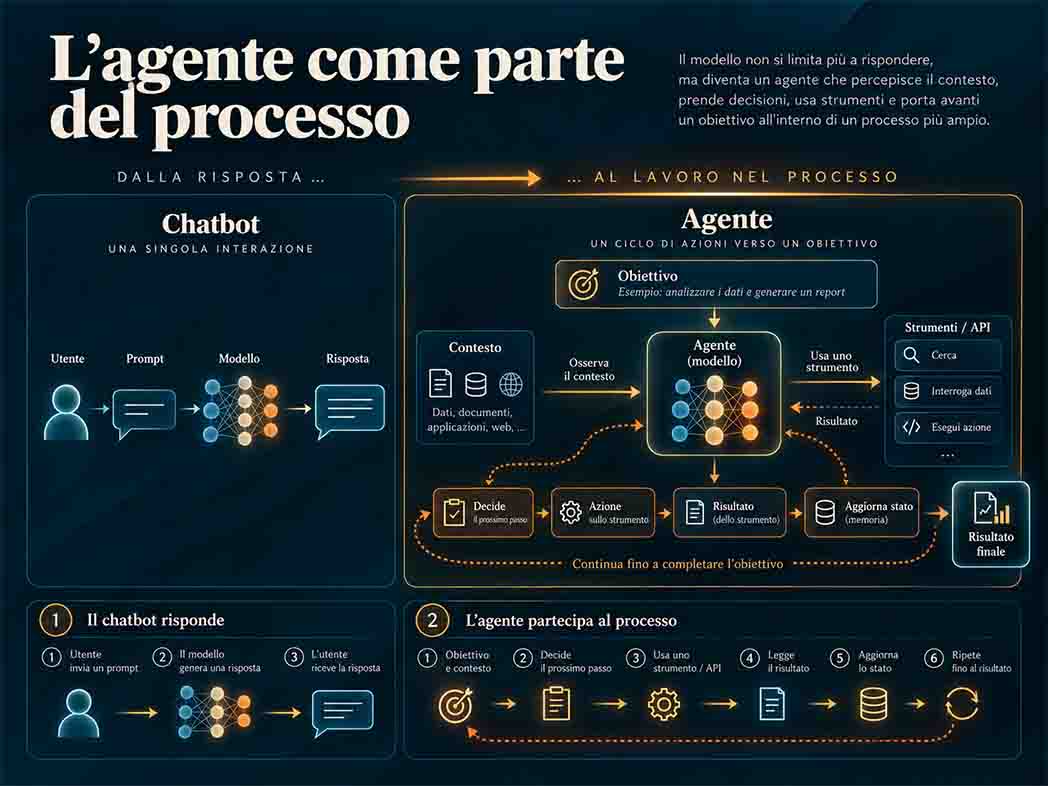
Il passaggio successivo è quello che stiamo vivendo adesso. Per anni abbiamo usato i modelli soprattutto come interlocutori: facevamo una domanda, ricevevamo una risposta, eventualmente correggevamo il prompt e ricominciavamo.
Un agente introduce qualcosa di diverso: il modello non si limita più a produrre l’output finale, ma può partecipare alla sequenza di operazioni necessarie per raggiungere un obiettivo.
CHATBOT

utente
  ↓
prompt
  ↓
LLM
  ↓
risposta
Con un agente il ciclo diventa più simile a questo:
AGENTE

obiettivo
   ↓
osserva il contesto
   ↓
decide il prossimo passo
   ↓
usa un tool
   ↓
legge il risultato
   ↓
aggiorna lo stato
   ↓
decide di nuovo
   ↓
...
   ↓
risultato
La differenza è sostanziale. Se chiediamo a un chatbot:
“Qual è il volo più economico per Londra?”
può spiegarci come cercarlo o, se dispone di informazioni aggiornate, indicarci alcune possibilità.
Un agente, invece, può ricevere l’obiettivo, interrogare servizi esterni, confrontare opzioni, applicare vincoli, chiedere un chiarimento quando manca un’informazione e proseguire finché il compito non è completato o richiede una decisione umana.
Il modello diventa quindi una sorta di motore decisionale locale dentro un workflow.
Non significa necessariamente che sia autonomo in senso forte. Un buon sistema agentico può prevedere molti livelli diversi di autonomia:
modello suggerisce
        ↓
software verifica
        ↓
persona approva
        ↓
sistema esegue
oppure:
modello decide
        ↓
tool esegue
        ↓
modello verifica il risultato
        ↓
continua automaticamente
La quantità di libertà concessa dipende dal rischio del compito. Generare una bozza di email non richiede gli stessi controlli di un sistema che modifica un database, effettua un pagamento o concede l’accesso a un’infrastruttura.
Per questo parlare semplicemente di “agenti AI” può essere fuorviante. Dietro un agente affidabile continuano a esserci software tradizionale, permessi, regole, validazioni, log, limiti e punti di approvazione umana. Il modello può scegliere una direzione, ma è l’architettura a stabilire quali azioni siano realmente disponibili.
Cambia anche il ruolo della memoria. Una conversazione può permettersi di dimenticare quasi tutto quando finisce. Un agente che deve seguire un processo per ore, giorni o settimane ha invece bisogno di sapere che cosa è già successo, quali decisioni sono state prese, quali risultati sono stati ottenuti e che cosa resta da fare.
Lo stato diventa quindi parte essenziale del sistema:
GOAL

↓ stato iniziale

ACTION 1
↓
OBSERVATION

↓ nuovo stato

ACTION 2
↓
OBSERVATION

↓ nuovo stato

ACTION 3
↓
...
In alcuni casi questa architettura viene ulteriormente suddivisa. Un agente principale può delegare attività specifiche ad altri componenti specializzati: uno ricerca informazioni, uno analizza dati, uno scrive codice, uno verifica il risultato. Non perché sia necessario imitare un’azienda popolata da piccoli lavoratori digitali, ma perché separare responsabilità e contesti può rendere un sistema complesso più gestibile.
E qui emerge forse la trasformazione più importante rispetto al 2022.
Allora il valore di un modello veniva percepito soprattutto nella qualità della sua risposta.
Oggi cominciamo a valutarlo anche per la sua capacità di:
capire uno stato, scegliere un’azione, utilizzare uno strumento, osservare cosa è successo e decidere il passo successivo.
Il modello non è più necessariamente il luogo in cui un processo termina.
Può diventare uno dei soggetti che lo fanno avanzare.
Ed è proprio questo passaggio — da generatore di risposte a partecipante operativo — che ci porta verso la prossima fase: sistemi composti non da una singola intelligenza artificiale, ma da modelli, software, dati, strumenti e persone che collaborano all’interno dello stesso processo.
Dove stiamo andando: dall’LLM all’organizzazione di intelligenze
A questo punto il passaggio successivo appare quasi naturale. Se un modello può usare strumenti, mantenere stato, recuperare informazioni, delegare compiti e lavorare insieme ad altri modelli, allora il futuro prossimo dell’AI non assomiglia più a un’unica intelligenza centrale che sa fare tutto.
Assomiglia molto di più a un sistema composto.
persona
   ↓
orchestratore
   ↓
┌─────────────┬─────────────┬─────────────┐
│ agente dati │ agente code │ agente web  │
└─────────────┴─────────────┴─────────────┘
       ↓             ↓             ↓
     API         database        tools
       \             |             /
        └────── stato condiviso ───┘
                    ↓
               risultato
Le piattaforme agentiche stanno già andando in questa direzione. I framework moderni prevedono non soltanto tool calling, ma handoff tra agenti, specialisti con contesti separati, stato persistente, guardrail, human review e orchestrazione multi-step. OpenAI, per esempio, distingue esplicitamente tra agenti che passano il controllo a uno specialista e agenti “manager” che mantengono la responsabilità finale utilizzando altri agenti come strumenti. OpenAI Developers
Questo però non significa che costruire più agenti sia automaticamente meglio. Al contrario, la complessità cresce rapidamente. Ogni nuovo agente introduce un altro contesto da gestire, un’altra possibilità di errore, un altro punto da osservare e valutare. La stessa documentazione dei sistemi multi-agent raccomanda di separare i compiti soltanto quando esistono responsabilità realmente indipendenti o contesti che conviene isolare. OpenAI Developers
Il punto interessante è un altro: stiamo imparando a distribuire l’intelligenza.
Una parte può stare nel modello.
Una parte nelle regole del software.
Una parte nei dati.
Una parte in strumenti esterni.
Una parte in altri modelli specializzati.
E una parte, inevitabilmente, nelle persone che definiscono obiettivi, approvano decisioni e intervengono quando il sistema incontra un caso che non dovrebbe gestire da solo.
Possiamo quindi immaginare l’evoluzione degli ultimi anni come una sequenza:
LLM
↓
assistant
↓
assistant + retrieval
↓
assistant + tools
↓
agent
↓
multi-agent workflow
↓
sistema ibrido uomo + software + AI
Ed è probabilmente qui che la discussione sui modelli rischia di diventare fuorviante. Continueremo certamente a confrontare GPT, Claude, Gemini, Llama, DeepSeek e ciò che verrà dopo. Le differenze tra modelli continueranno a contare. Ma per molte applicazioni reali saranno soltanto una delle variabili dell’equazione.
Sempre più spesso il vantaggio non arriverà dal possedere il modello con il benchmark migliore, ma dal saper progettare meglio:
il contesto che riceve, i dati a cui accede, gli strumenti che può usare, le regole che lo limitano, gli altri componenti con cui collabora e il modo in cui il suo comportamento viene osservato e valutato.
È forse questo il cambiamento più profondo iniziato nel 2022.
Siamo partiti da una finestra in cui scrivevamo una frase e aspettavamo che una macchina la completasse.
Stiamo arrivando a sistemi nei quali modelli linguistici, software e persone condividono pezzi dello stesso processo.
Ed è per questo che, paradossalmente, mentre i modelli diventano sempre più importanti, il nome del modello potrebbe contare sempre meno.
A contare davvero sarà ciò che riusciremo a costruirgli intorno.
Studio digital growth dal 1969, quando l'uscita di Abbey Road trasformò il modo di fruire la musica. Sono un data driven specialist, il mio lavoro è portare traffico qualificato sui siti web. Ho una laurea110L con tesi in sistemi economici comparati e un bellissimo computer. Fumo poco e ascolto il groove.
Richiedi info